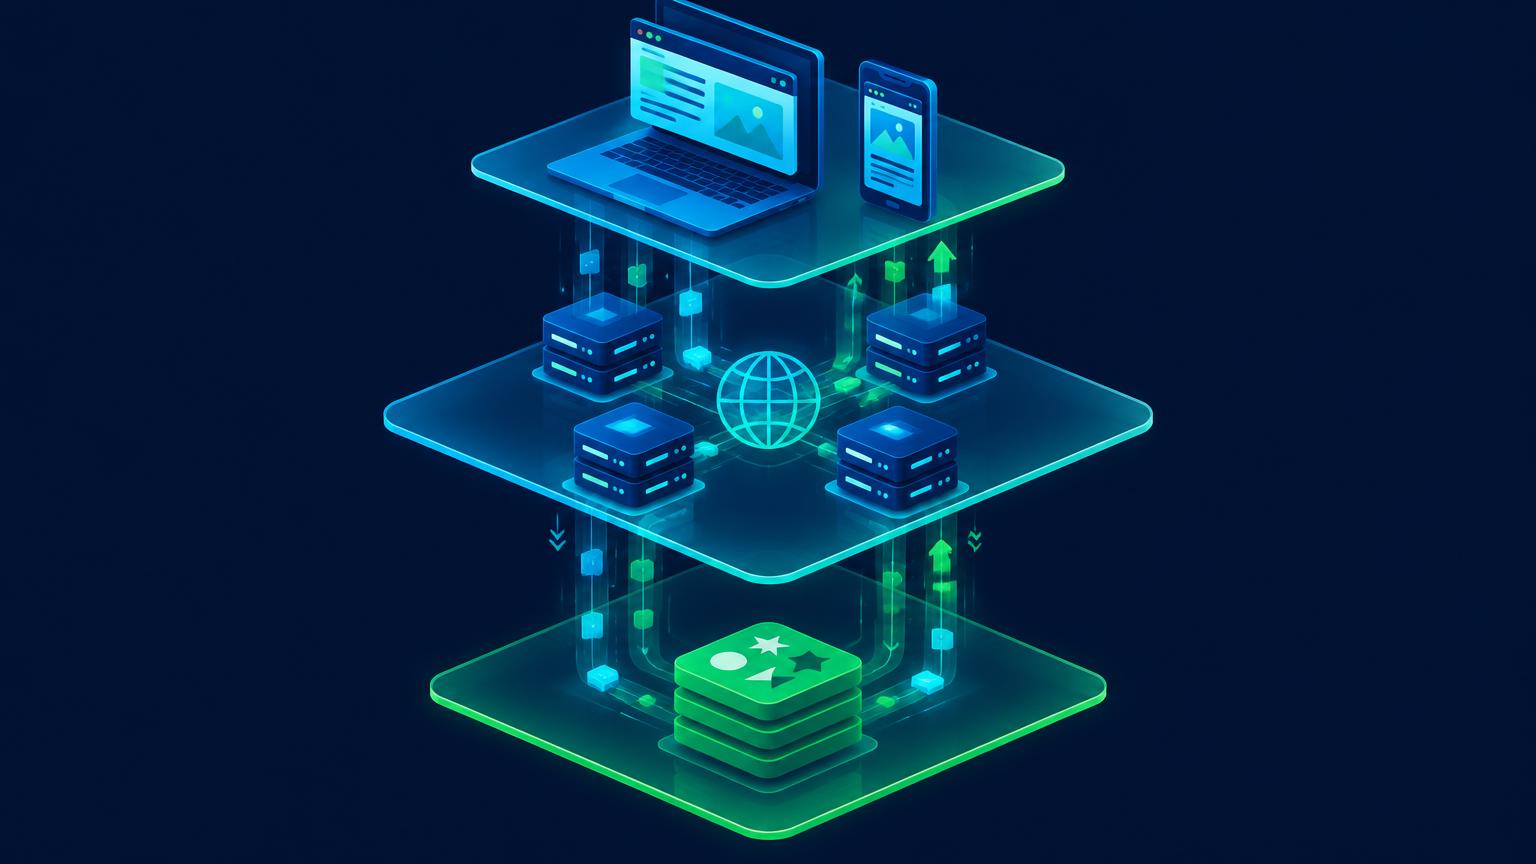
Cache é guardar uma resposta já calculada para não precisar calculá-la de novo. Bem usado, reduz o tempo de carregamento e o custo de servidor; mal usado, mostra preço antigo, página desatualizada ou — no pior caso — dados de um usuário para outro. A pergunta útil não é "devo usar cache?", e sim "em qual camada, por quanto tempo e como invalidar". Este guia responde a essas três perguntas com exemplos de configuração.
As camadas de cache de uma requisição
Entre o clique do usuário e o banco de dados existem vários pontos onde uma resposta pode ser reaproveitada. Cada um é controlado de um jeito diferente:
| Camada | Onde fica | Quem controla | Bom para |
|---|---|---|---|
| Navegador | Na máquina do visitante | Cabeçalho Cache-Control da resposta | CSS, JavaScript e imagens com hash no nome |
| CDN | Servidores de borda do provedor, perto do usuário | Cache-Control (s-maxage) e regras do provedor | HTML público, imagens, respostas de API públicas |
| Aplicação | Memória do processo ou Redis | O código da aplicação | Resultados de consultas caras, chamadas a APIs externas |
| Banco de dados | Memória do próprio SGBD | Configuração do banco | Páginas de dados acessadas com frequência |
A regra geral: quanto mais perto do usuário, mais rápido e mais barato — e mais difícil de invalidar. Um arquivo guardado no navegador do visitante só será buscado de novo quando o prazo vencer ou a URL mudar.
Os cabeçalhos HTTP que importam
- max-age=N: por quantos segundos a resposta pode ser reutilizada sem perguntar ao servidor.
- s-maxage=N: o mesmo, mas só para caches compartilhados (CDN, proxies). Sobrepõe max-age nessas camadas.
- no-cache: pode guardar, mas precisa revalidar com o servidor antes de cada uso. Não significa "não guarde".
- no-store: não guarde em lugar nenhum. É o correto para dados sensíveis.
- private / public: private proíbe caches compartilhados; public permite, mesmo em respostas que normalmente não seriam cacheadas.
- immutable: avisa que o conteúdo nunca muda nessa URL, evitando revalidações desnecessárias.
- stale-while-revalidate=N: durante N segundos após vencer, entrega a cópia antiga e atualiza em segundo plano.
- ETag e Last-Modified: identificadores de versão que permitem ao servidor responder 304 Not Modified, sem reenviar o corpo.
- Vary: informa quais cabeçalhos da requisição mudam a resposta (por exemplo, Accept-Encoding), para o cache guardar versões separadas.
Na prática, três receitas cobrem a maior parte dos casos:
# Arquivos com hash no nome (app.3f9a1c.js): o conteúdo nunca muda nessa URL
Cache-Control: public, max-age=31536000, immutable

# HTML de um artigo: a CDN guarda por 5 min; o navegador sempre revalida
Cache-Control: public, max-age=0, s-maxage=300, stale-while-revalidate=60

# Página com dados do usuário logado
Cache-Control: private, no-store
A primeira receita só é segura porque o nome do arquivo muda a cada build: quando o código muda, a URL muda, e o navegador nunca usa a versão errada. Ferramentas como Vite e webpack já geram esses nomes automaticamente.
Revalidação com ETag
Quando o conteúdo muda sem aviso, a revalidação evita baixar de novo o que não mudou. O servidor envia um ETag; na próxima vez, o navegador o devolve em If-None-Match e, se nada mudou, recebe um 304 sem corpo:
import { createHash } from "node:crypto";

export async function handler(req: Request): Promise<Response> {
  const body = JSON.stringify(await listarProdutos());
  const etag = `"${createHash("sha1").update(body).digest("hex")}"`;

  if (req.headers.get("if-none-match") === etag) {
    return new Response(null, { status: 304, headers: { ETag: etag } });
  }

  return new Response(body, {
    headers: {
      "Content-Type": "application/json",
      "Cache-Control": "no-cache",
      ETag: etag,
    },
  });
}
Repare na limitação: o servidor ainda consulta o banco e monta a resposta para calcular o ETag. A economia é de banda e de tempo de transferência, não de processamento. Para poupar o banco, é preciso cache na aplicação.
Cache na aplicação com Redis: o padrão cache-aside
No padrão cache-aside, a aplicação procura primeiro no cache; se não encontrar, busca no banco e grava o resultado com prazo de validade. Ao alterar o dado, apaga a chave correspondente. O exemplo usa o cliente oficial node-redis:
import { createClient } from "redis";

const redis = createClient({ url: process.env.REDIS_URL });
await redis.connect();

export async function buscarProduto(id: string) {
  const chave = `produto:${id}:v1`;
  const emCache = await redis.get(chave);
  if (emCache) return JSON.parse(emCache);

  const produto = await db.produto.findUnique({ where: { id } });
  if (produto) {
    await redis.set(chave, JSON.stringify(produto), { EX: 300 }); // 5 minutos
  }
  return produto;
}

export async function atualizarProduto(id: string, dados: Partial<Produto>) {
  await db.produto.update({ where: { id }, data: dados });
  await redis.del(`produto:${id}:v1`); // invalida depois de gravar
}
Três detalhes fazem diferença. O prazo de validade (EX) funciona como rede de segurança: mesmo que uma invalidação falhe, o dado velho some sozinho. O sufixo v1 na chave permite mudar o formato do objeto sem conflito com o que já está guardado. E a invalidação vem depois da gravação no banco — invertendo a ordem, outra requisição pode repor o valor antigo no intervalo.
Os problemas clássicos e como evitá-los
Dado desatualizado
Toda camada de cache troca atualidade por velocidade. Defina, para cada tipo de dado, quanto atraso é aceitável: o texto de um artigo tolera minutos; o saldo de uma conta, nenhum. Dados que não toleram atraso não devem ser cacheados — ou devem ser invalidados no momento da escrita.
Cache stampede
Quando uma chave muito acessada expira, centenas de requisições simultâneas descobrem que o cache está vazio e vão todas ao banco ao mesmo tempo. As defesas mais comuns são: adicionar uma variação aleatória ao prazo (para as chaves não vencerem juntas), permitir que só uma requisição recalcule enquanto as outras aguardam ou recebem a versão antiga, e usar stale-while-revalidate nas camadas HTTP.
Vazamento de dados privados
O erro mais grave é deixar uma CDN guardar uma página personalizada: o próximo visitante recebe a página do anterior. Respostas que dependem de cookie ou de sessão devem levar private ou no-store. Revise isso sempre que adicionar login a um site que já usava CDN.
Chaves que não existem
Consultas por ids inexistentes nunca encontram nada no cache e sempre vão ao banco. Se isso for frequente (bots, links quebrados), guarde também o resultado vazio por um prazo curto.
Checklist antes de colocar em produção
- Liste os tipos de resposta do sistema e o atraso aceitável de cada um.
- Arquivos estáticos com hash no nome: max-age longo e immutable.
- HTML público: s-maxage curto na CDN e stale-while-revalidate.
- Qualquer resposta com dados do usuário: private ou no-store.
- Cache na aplicação só para operações medidamente caras, sempre com prazo de validade.
- Invalidação escrita junto com o código que altera o dado, e coberta por teste.
- Monitore a taxa de acerto do cache: abaixo de 50%, ele provavelmente está custando mais do que economiza.
Conclusão
Cache não é uma otimização que se liga e esquece. Comece pelas camadas mais simples — cabeçalhos corretos para arquivos estáticos e HTML público — e só adicione Redis quando uma medição mostrar uma consulta cara e repetida. Para cada dado cacheado, você deve saber responder: onde está guardado, por quanto tempo e o que acontece quando ele muda.
Perguntas frequentes
+Qual a diferença entre no-cache e no-store?
no-cache permite guardar a resposta, mas obriga a confirmar com o servidor antes de reutilizá-la (normalmente via ETag, recebendo 304 se nada mudou). no-store proíbe guardar a resposta em qualquer lugar e é o indicado para dados sensíveis.
+Preciso de Redis para ter cache?
Não. Cabeçalhos HTTP corretos e uma CDN resolvem a maior parte dos ganhos em sites de conteúdo. Redis faz sentido quando a própria aplicação repete consultas ou chamadas externas caras, ou quando vários servidores precisam compartilhar o mesmo cache.
+Cache em memória do processo serve?
Serve para dados pequenos e que podem divergir entre instâncias por alguns segundos, como configurações. Com vários servidores ou funções serverless, cada instância tem sua própria cópia e a invalidação não chega a todas — nesses casos, um cache compartilhado como o Redis é mais previsível.
+Como forçar os visitantes a receberem um CSS novo?
Mude a URL do arquivo. Por isso os empacotadores incluem um hash do conteúdo no nome (app.3f9a1c.css): quando o conteúdo muda, o HTML passa a apontar para outro arquivo e o cache antigo simplesmente deixa de ser usado.
Fontes consultadas
- MDN — Cache-Control
- RFC 9111 — HTTP Caching
- RFC 5861 — stale-while-revalidate e stale-if-error
- web.dev — Love your cache
- Redis — comando EXPIRE
Histórico: publicado em . Conteúdo educativo, sem patrocínio das ferramentas citadas. Encontrou um erro? Envie uma correção.
Leia também
Expressões regulares na prática: guia com exemplos em JavaScript e Python
O que são expressões regulares, a sintaxe essencial em uma tabela, exemplos testáveis em JavaScript e Python (datas, CEP, logs), diferença entre ganancioso e preguiçoso e como evitar ReDoS.
Serverless: quando funções serverless valem a pena (e quando viram armadilha)
AWS Lambda, Cloudflare Workers e Vercel Functions comparados: modelo de custo, cold starts, limites de execução e os workloads onde serverless brilha ou falha.
Core Web Vitals na prática: LCP, INP e CLS medidos e corrigidos
Guia técnico dos três Core Web Vitals: como medir com dados reais (CrUX/RUM), as causas mais comuns de LCP, INP e CLS ruins e as correções que funcionam.